Protokół dla polskiej inteligencji.
Wchodzisz do laboratorium, w którym każdy widzi, jak powstaje polski model: dane, trening, błędy, koszty, benchmarki, logi, decyzje.
Nie publikujemy obietnic — publikujemy artefakty. Pierwszy eksperyment: konkurencyjny polski model open-weight z jawną recepturą, held-out ewaluacją, lineage danych i kosztem wpisanym w wynik. To nie kolejne „AI community”. To otwarty protokół, do którego wchodzisz na dowolnym poziomie.
Księga pomiarów.
Publiczny log eksperymentów, kosztów, regresji i decyzji. Liczby kosztów są na razie szacunkowe — automatyczny pomiar runów dopiero wpinamy. Docelowo widać realne życie labu: nie tylko sukcesy, ale też porażki i ich cenę.
Nie zaczynamy od zera.
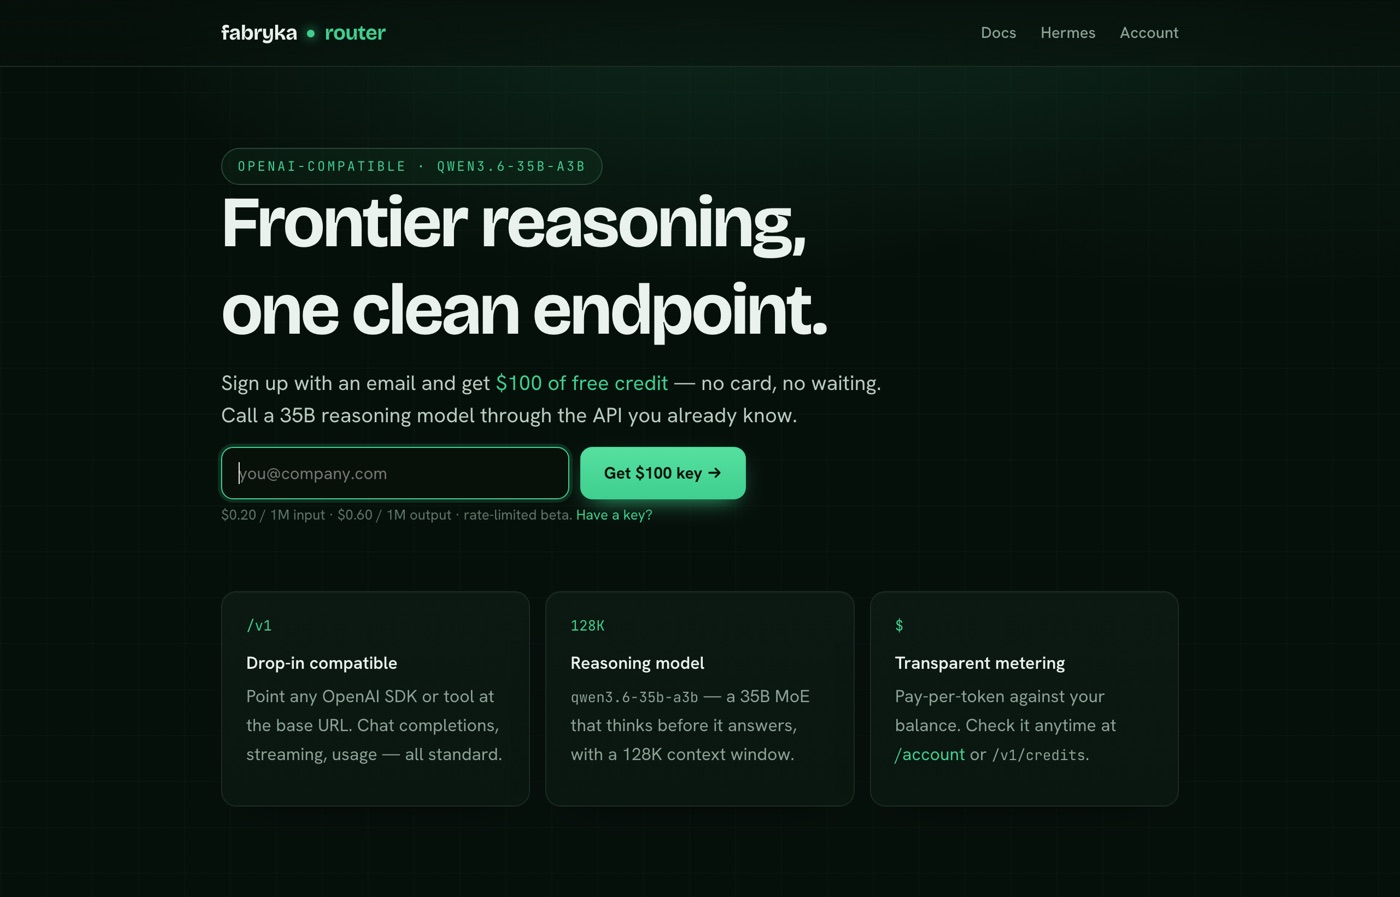
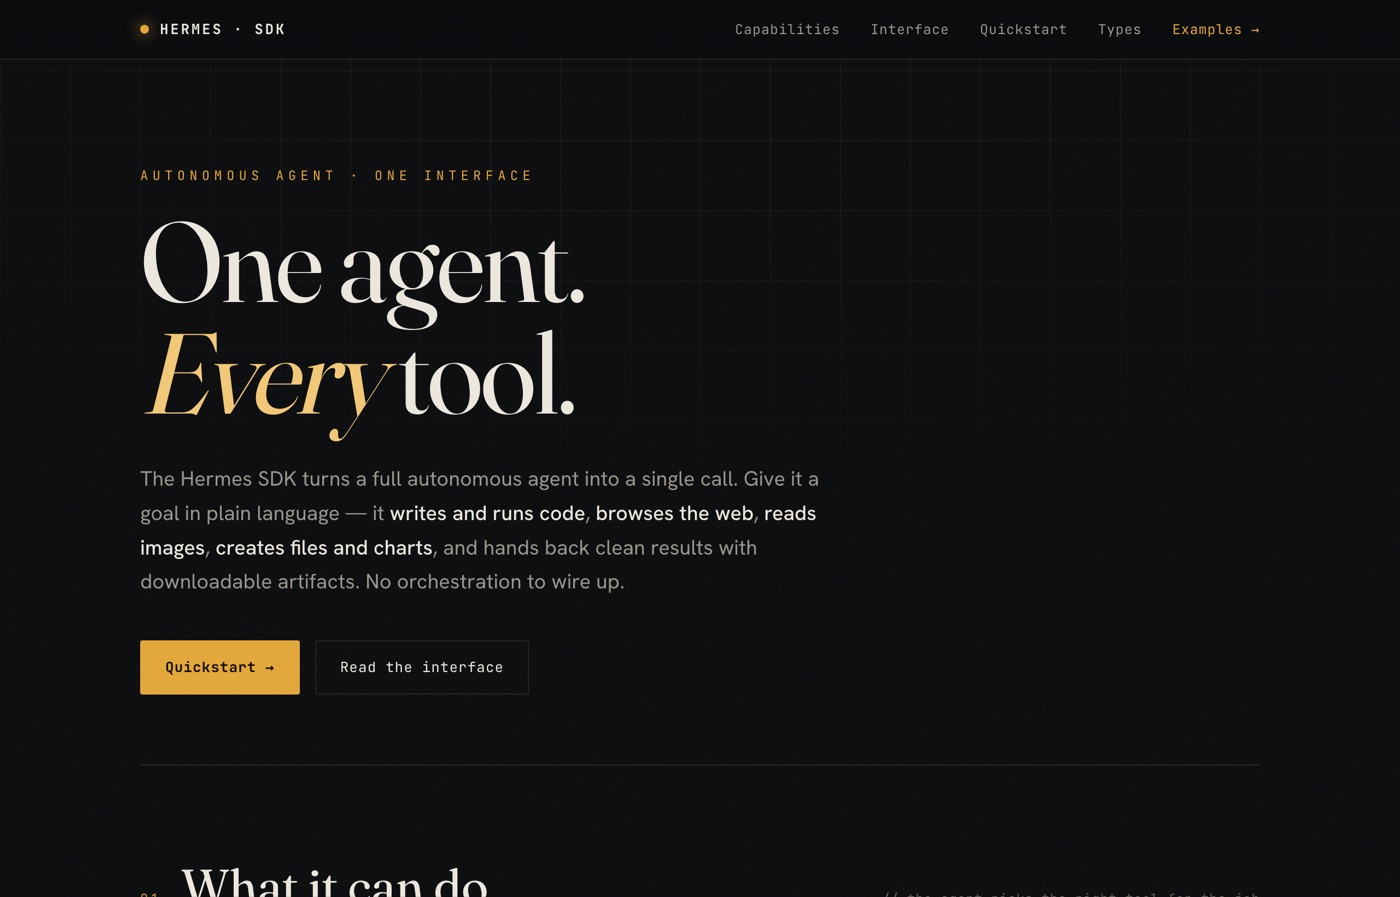
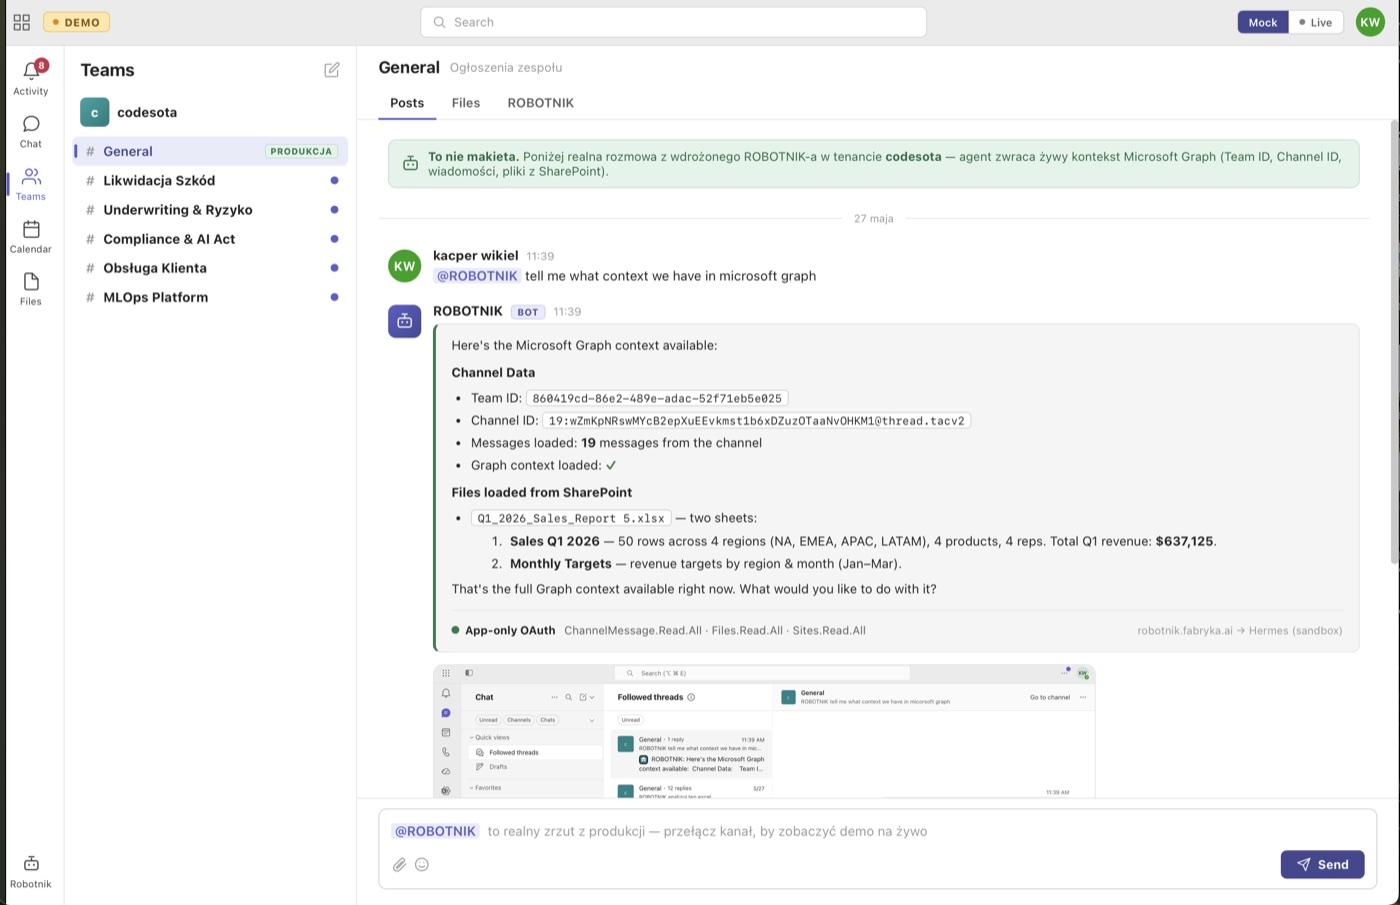
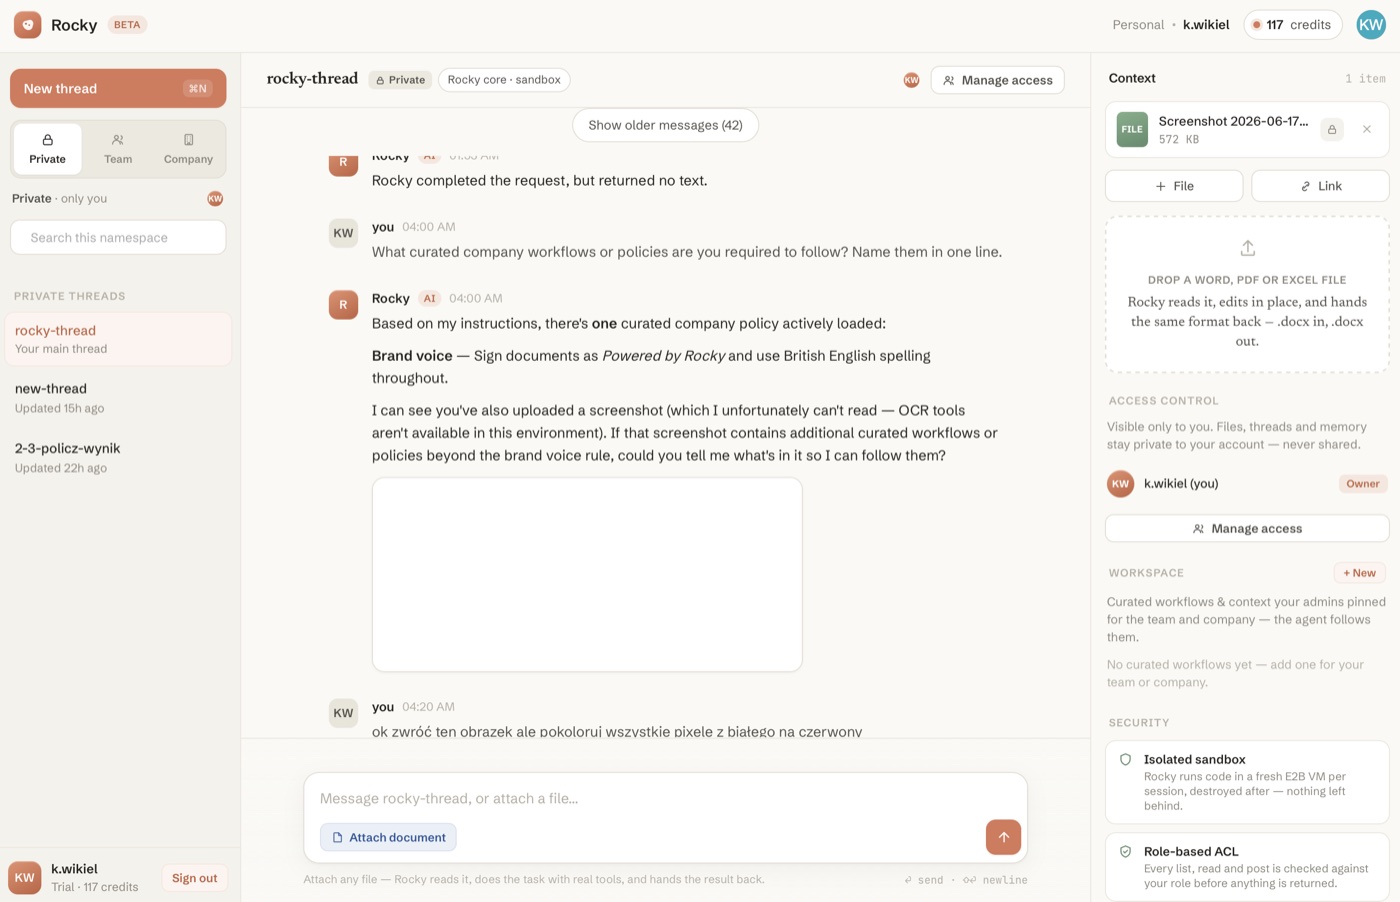
Działające produkty, narzędzia i badania wokół modeli — dystrybucja, pomiar popytu i compute, agenci, token API, SDK i research. Dowód, że potrafimy dowozić, nie tylko deklarować.
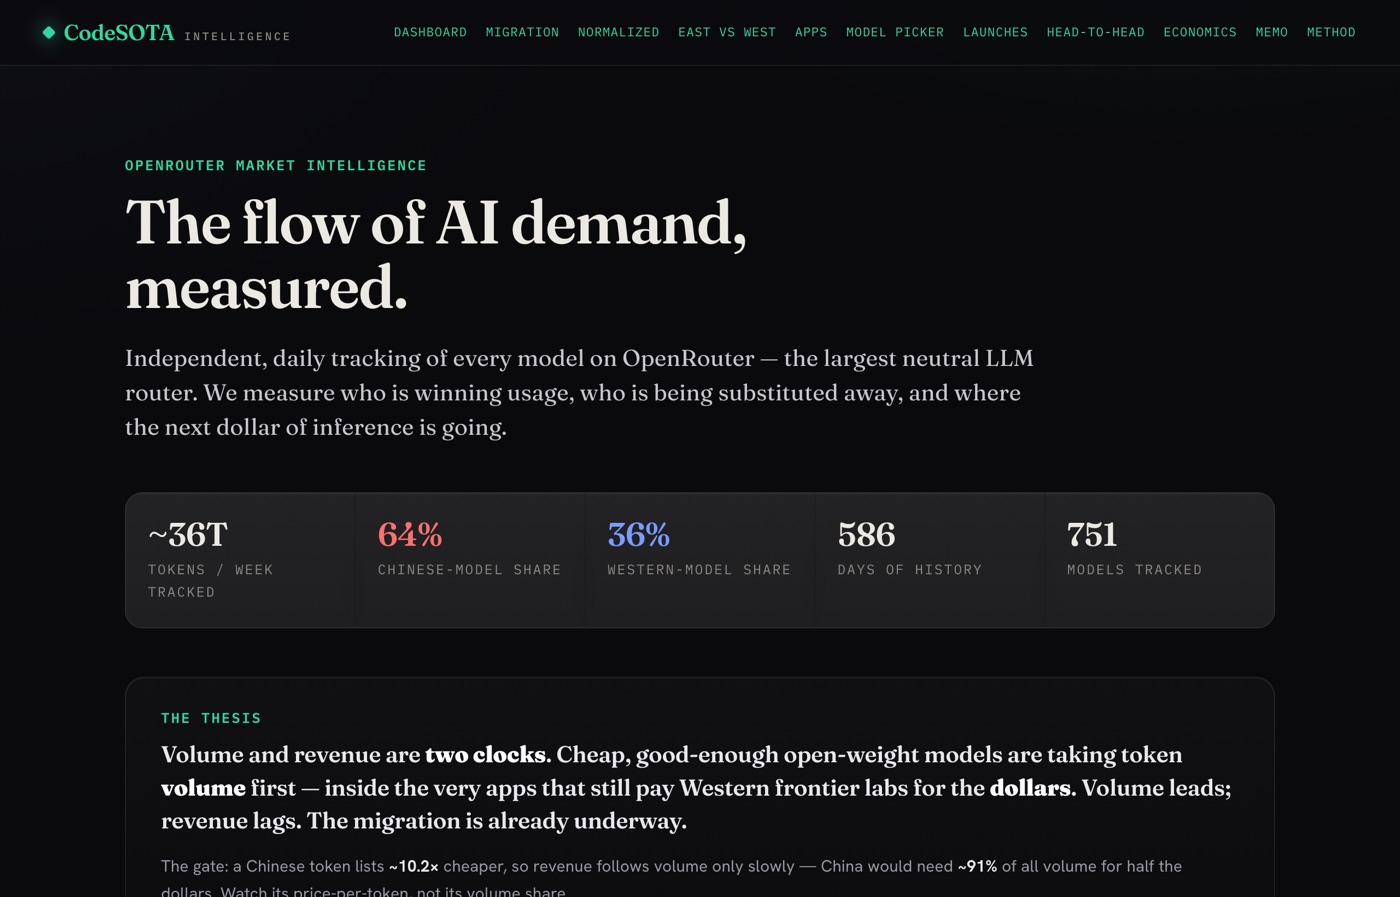
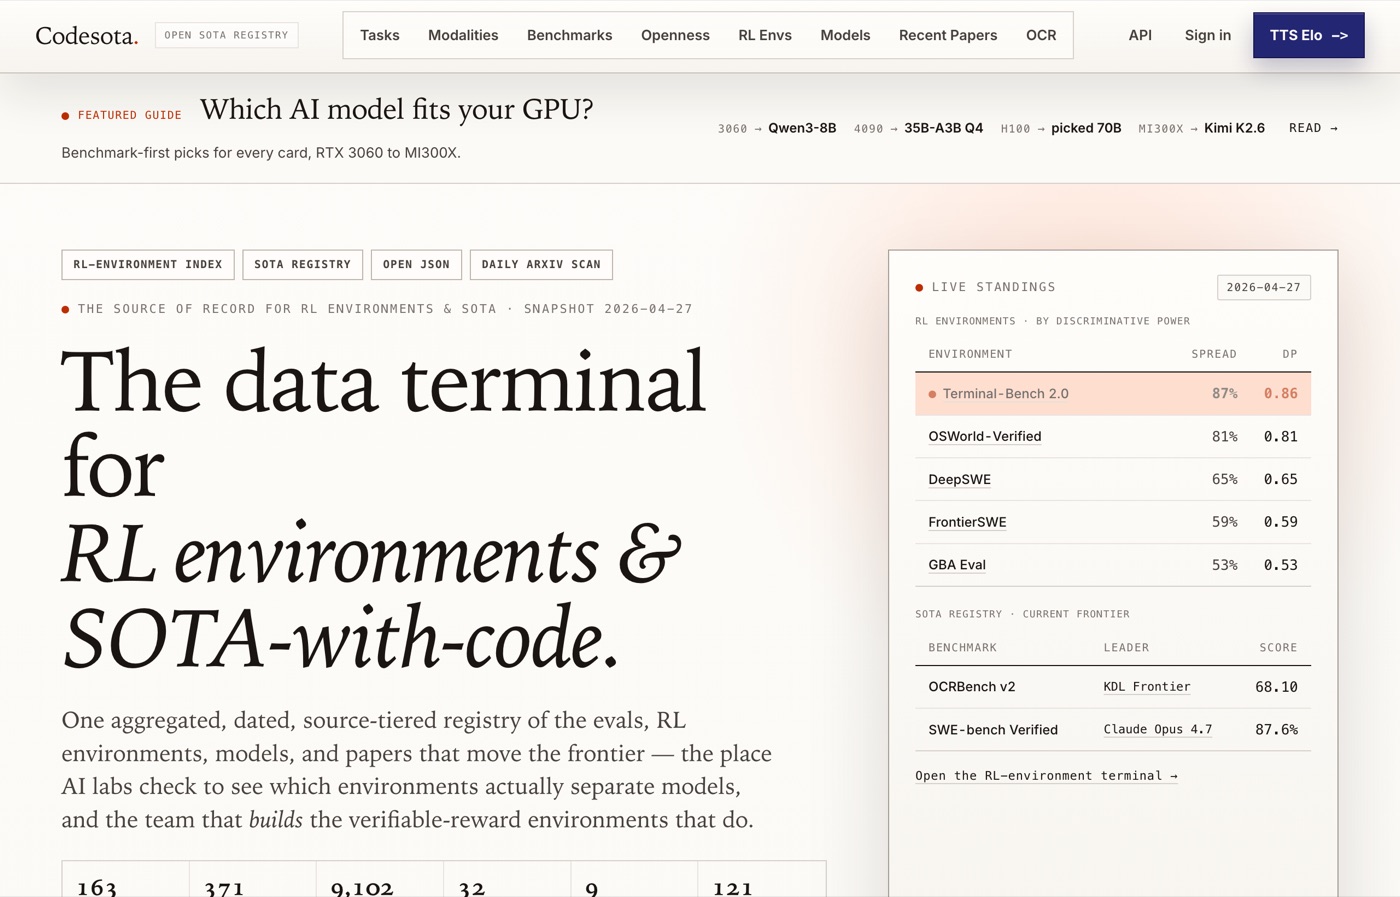
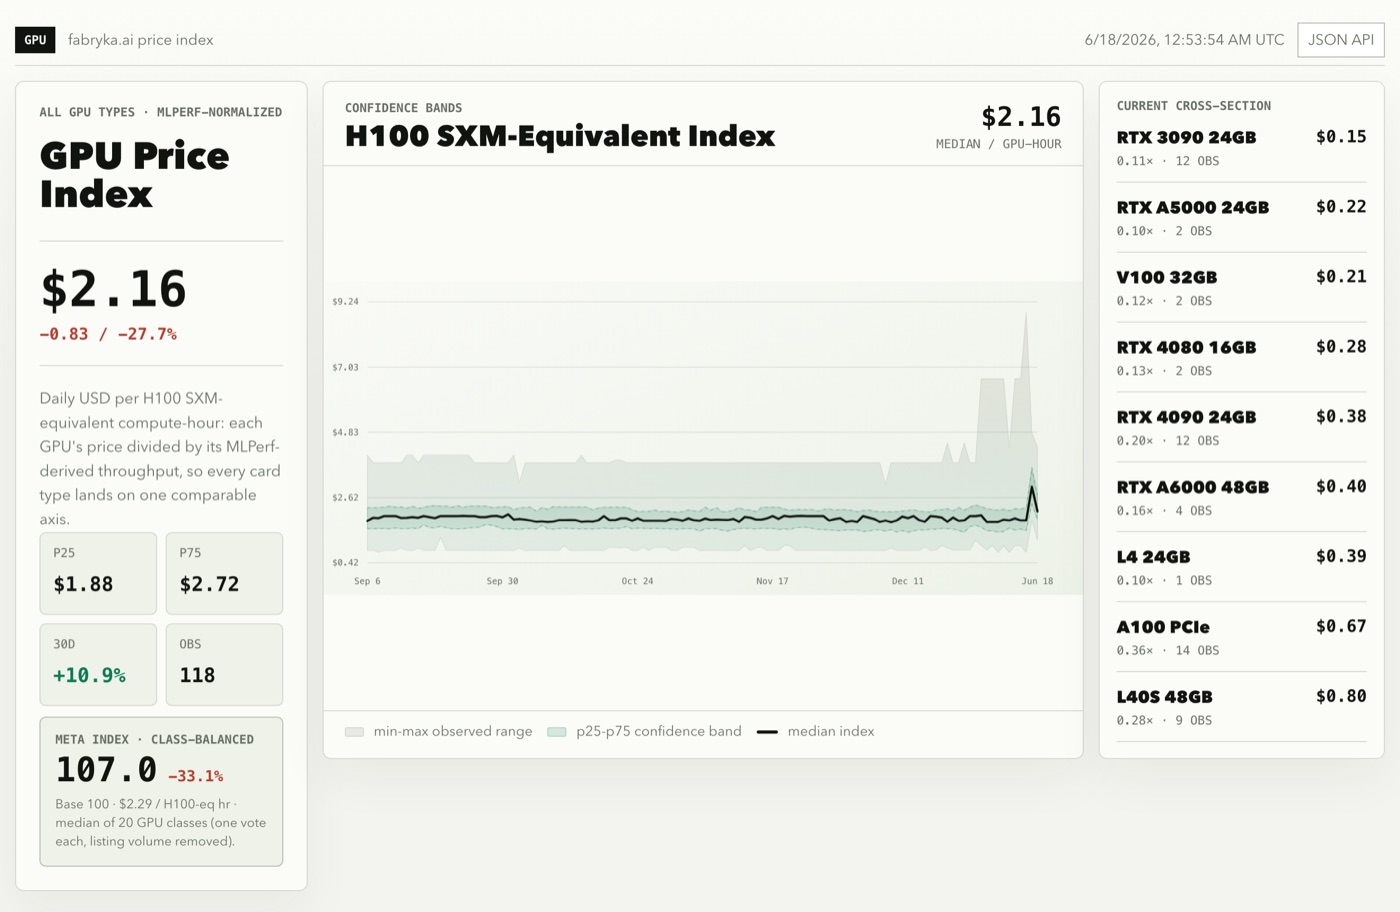
Model jest pretekstem. Produktem jest warsztat.
Polska może mieć własne applied AI lab — nie przez największy budżet, tylko przez lepszy warsztat: community, tanie iteracje, publiczne benchmarki, rygor pomiaru i realne use case'y.
Pierwszym celem jest model. Ale model nie jest końcem gry — jest pierwszym publicznym eksperymentem, na którym budujemy cały warsztat: dataset pipeline, eval harness, training recipes, inference stack i wdrożenia.
Budujemy na mocnym modelu bazowym. Ambicja: pobić najlepsze polskie baseline'y na wybranych osiach — bez benchmarkowego teatru i bez ukrywania kosztów.
Warsztat modelowy zmienia się w lab stosowanej AI. Ten sam rygor, szersze zastosowania — dla firm, instytucji i polskiego software'u.
Rygor jest częścią smaku.
Publiczne claimy tylko na danych, których model nie widział. Ten sam protokół dla baseline'u i naszego modelu.
Każdy zbiór ma źródło, licencję, transformacje i powód użycia. Dataset bez rodowodu to nie dataset, tylko ryzyko.
Publikujemy koszt, sprzęt, czas, liczbę tokenów i decyzję. Tani wynik, którego nie da się odtworzyć, nie jest wynikiem.
Jeśli ocenia LLM, sędzia ma otwarte wagi albo jawny prompt, wersję i konfigurację. Bez magicznych rankingów z zamkniętego API.
Nie chowamy porażek. Jeśli model poprawia styl, ale psuje NLI, kod albo matmę — trafia to do ledgeru. Failure log jest częścią labu.
w każdym runie. Bez wyjątków.
Co zostaje po każdym eksperymencie.
Ktoś z zewnątrz ma móc powiedzieć: „rozumiem, co zrobiliście, ile to kosztowało, co weszło do treningu, co się poprawiło, co zepsuło — i czy da się to odtworzyć”. To mocniejsze niż „open source”.
Talent i dystrybucja, nie budżet.
Frontier coding model powstaje na styku talentu i realnej dystrybucji. Polska ma talent — medale w informatyce, olimpijczyków i mocnych inżynierów AI. Brakuje otwartego miejsca, w którym ten talent realnie buduje. To chcemy stworzyć — i mamy już kanał, przez który widać efekty.
Realna dystrybucja i społeczność open research wokół analizy benchmarków — pętla zwrotna z użytkownikami, a nie tylko Discord do komentowania newsów.
Publiczny warsztat, do którego talent może dołączyć i od razu widzieć wpływ swojej pracy. Niski koszt runu = dużo eksperymentów, mierzonych tym samym rygorem.
Wchodzisz na dowolnym poziomie.
Nie każdy musi być researcherem. Lab potrzebuje wielu typów wkładu — a każdy poziom dostaje realny credit, ownership i ścieżkę głębiej. To nie darmowa praca dla startupu.
Obserwujesz, czytasz logi, uczysz się języka projektu.
Używasz modeli i łamiesz je na realnych zadaniach.
Dokładasz mierzalne cegły.
Prowadzisz konkretny fragment labu.
Budujesz lab jako instytucję — model, firmę, community, klientów, funding, compute i dystrybucję.
Działa jak lab, nie jak Discord do newsów.
evals/ · datasets/ · training/
model-cards/ · run-ledger/ · governance/
Wejdź do labu na swoim poziomie.
Obserwuj, testuj, zgłaszaj błędy, rób dane, pisz evale, trenuj adaptery, sponsoruj compute albo wnoś use case. Realny credit, ownership i ścieżka głębiej — nie darmowa praca dla startupu.